Képet és hangot is ért az Apertus 1.5, négyszer hosszabb kontextussal
A nyílt modellek továbbra is csak szöveget írnak, de a projekt szerint fordításban és utasításkövetésben is javultak; a beszédfeldolgozás még kísérleti.
▶ 30 MÁSODPERCBEN
- MI TÖRTÉNT
- Az Apertus 1.5 kép- és hangértéssel, választható gondolkodási móddal és 262 144 tokenes kontextusablakkal frissíti a 8B és 70B modelleket.
- MIÉRT FONTOS
- A nyílt modelleket használó fejlesztők többféle bemenetet és hosszabb szövegeket dolgozhatnak fel, hozzáférhető súlyokkal, adatokkal és tanítási részletekkel.
Az Apertus 1.5 már képeket és hangot is képes értelmezni, válaszként viszont továbbra is kizárólag szöveget állít elő. A Swiss AI Apertus projektjének Hugging Face-en megjelent beszámolója szerint a 8B és 70B modellek négyszer hosszabb bemenetet kezelnek, pontosabban követik az utasításokat, és jobban használják az eszközöket. A gondolkodási mód külön bekapcsolható, a beszédfeldolgozás azonban még kísérleti.
Új bemenetek, változatlan modellfelépítés
A frissítés nem új modellarchitektúrára épül: az Apertus 1.0 tanítását folytatták szöveges, képi és hangadatokkal. A 8B változat további 4 billió, a 70B további 2 billió tokent kapott; így jutottak összesen 19, illetve 17 billió tokenig. A token a modell által feldolgozott adategység, nem feltétlenül egy teljes szó.
A képeket az Emu3.5 tokenizer alakítja feldolgozható egységekre: egy 512 × 512 képpontos kép 1 024 tokent jelent. A hangot a WavTokenizer kódolja, másodpercenként 40 tokennel. A 262 144 tokenes kontextusablak azt a keretet tágítja ki, amelyen belül a modell egyszerre tudja figyelembe venni a bemenetet; ez négyszerese az Apertus 1.0 lehetőségének.
A tanítás részleteit is megnyitják
Az utólagos finomhangolás felügyelt szakaszában, az SFT-ben 3,7 millió szöveges mintát, valamint kép- és beszédadatokat használtak. Ezt ellenőrizhető jutalmakkal végzett megerősítéses tanítás egészítette ki, mintegy 350 000 feladattal. A DPO és SDPO jelű, preferenciákra épülő igazítási lépések a társalgás minőségét, az eszközhasználatot, a biztonságot és az Apertus Chartának való megfelelést célozták.

A frissített modellek súlyai 2026. július 24-én kerültek fel a Hugging Face-re Apache 2.0 licenccel; a részletes ismertető október 15-én jelent meg. A projekt teljes nyíltságot ígér: nemcsak a letölthető súlyokat, hanem az adatokat, az alapelveket és a tanítás teljes leírását is hozzáférhetővé teszi.
Fordításban erős, de nem mindenben élvonalbeli
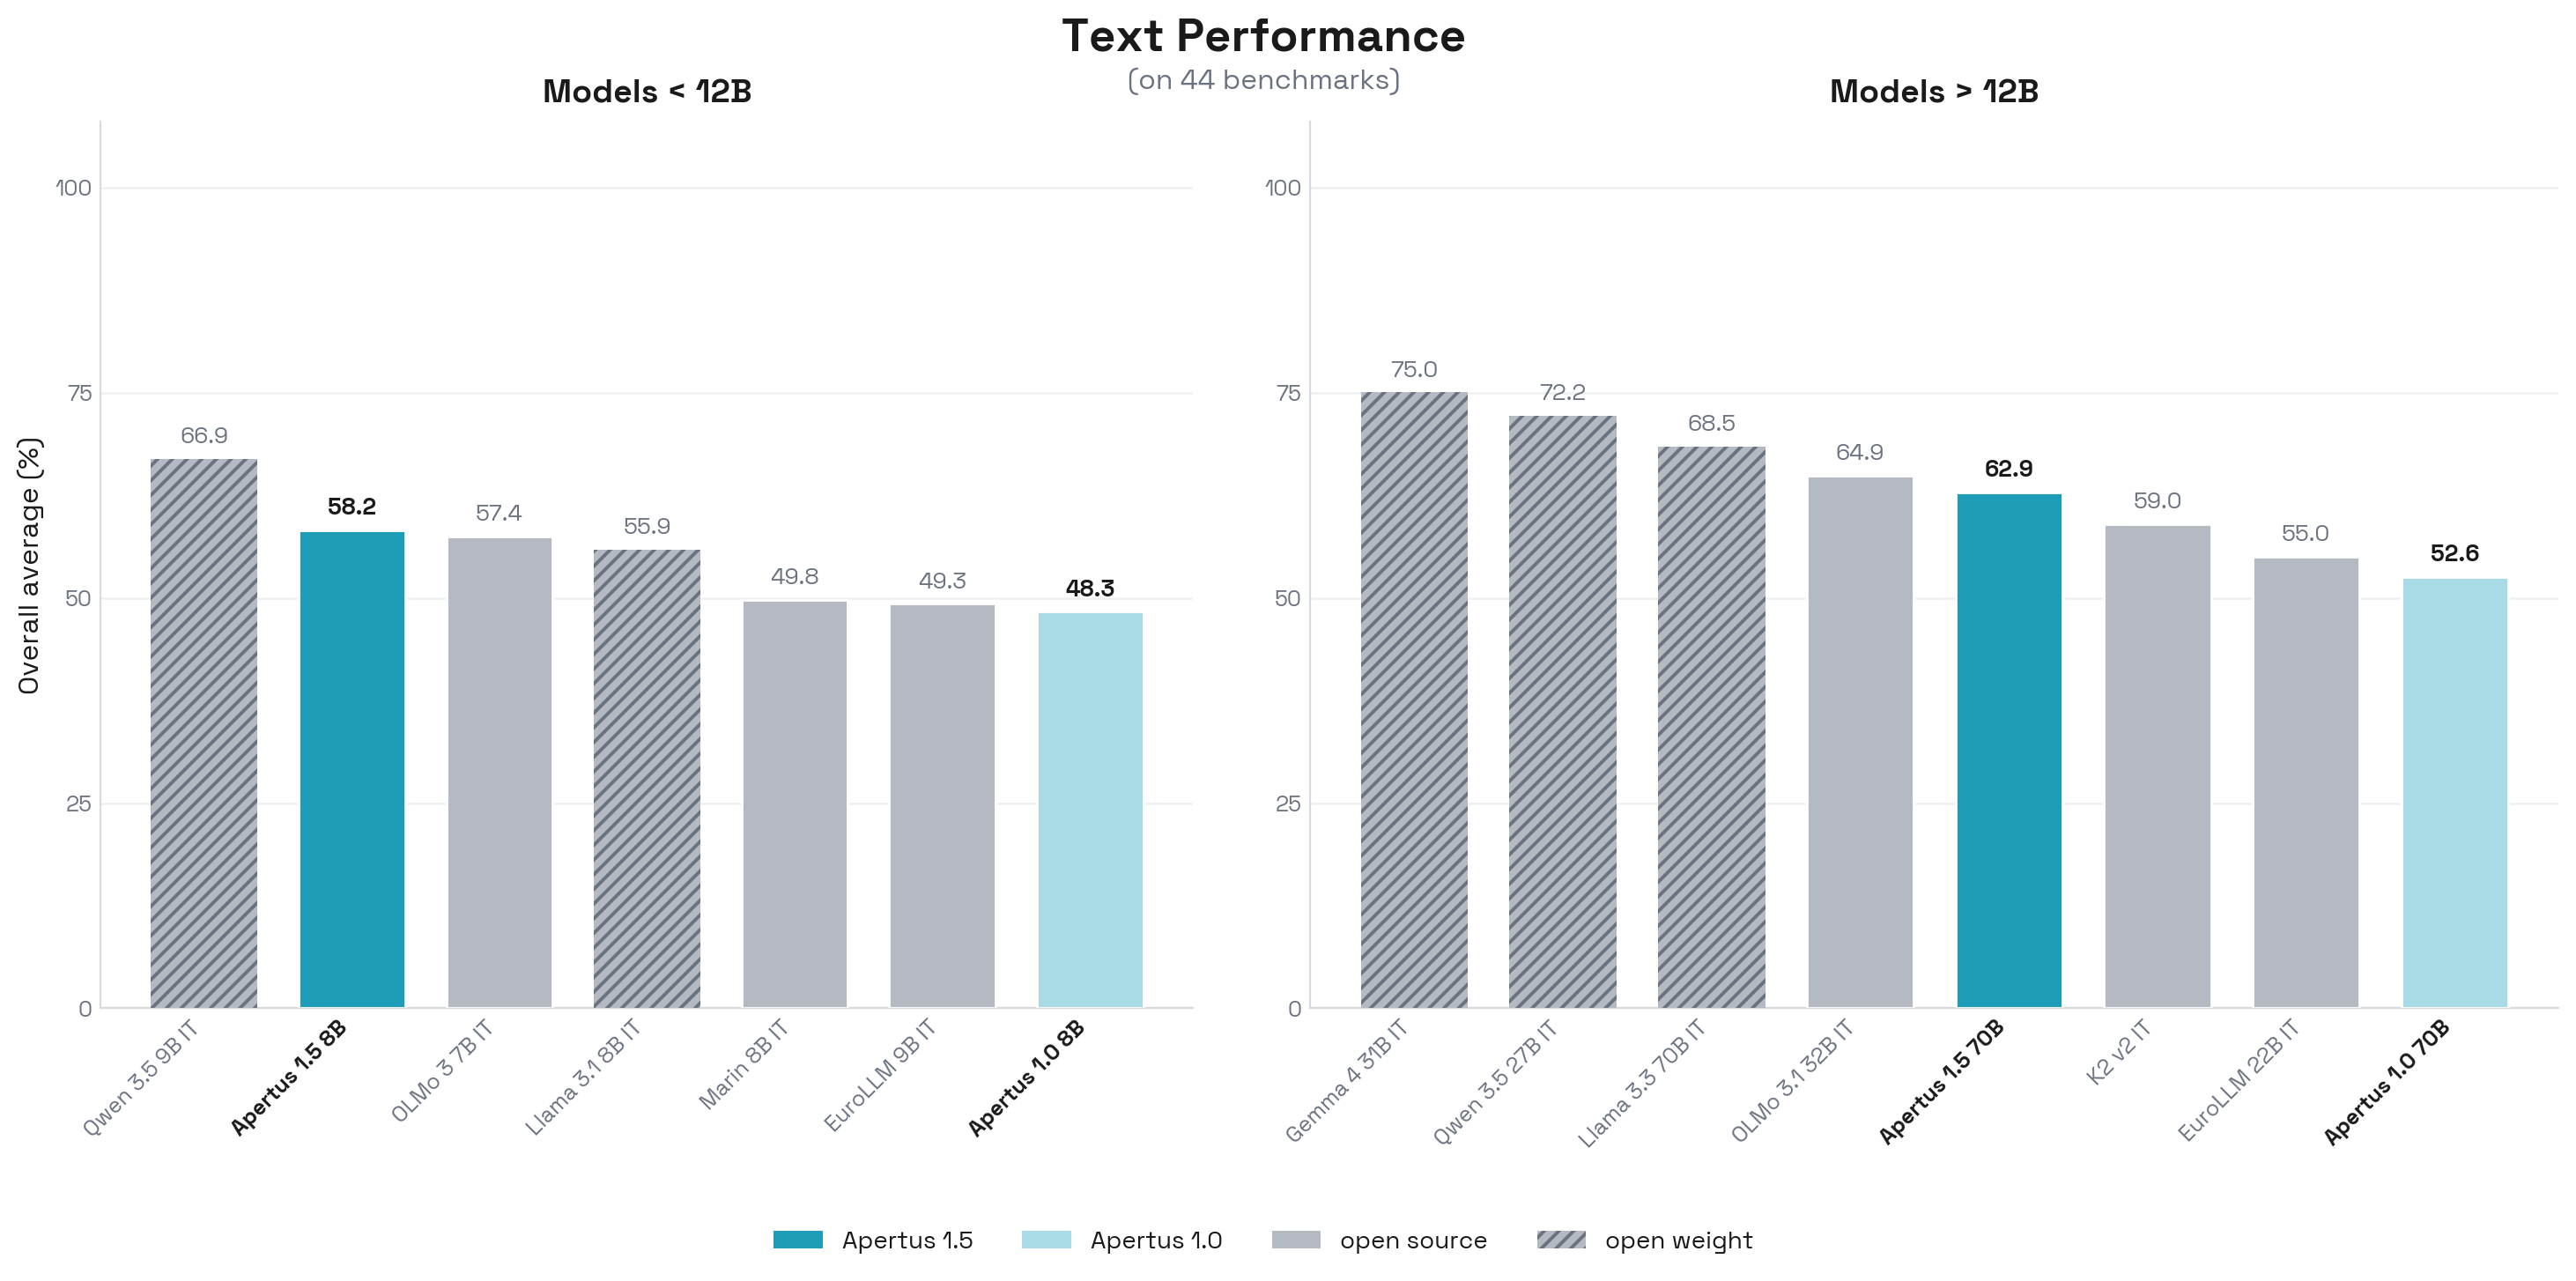
A projekt saját értékelése szerint az Apertus 1.5 továbbra is elmarad a vezető nyílt súlyú modellektől, a 8B változat azonban utasításkövetésben és többnyelvű feladatokban felülmúlja a hasonló méretű versenytársakat. A képi és hangos feladatokban mutatott teljesítményt a Gemma 4 12B és más jelenlegi nyílt súlyú modellek szintjéhez közelinek írják le. Svájci jogi feladatokon a vezető nyílt modellekkel egyenrangú eredményről számolnak be.
A Last Translation Benchmark fordítási teljesítményteszten a közlés szerint az Apertus 1.5 8B eléri a GPT-OSS-20B eredményét, és megelőzi a Claude Haiku 4.5-öt, valamint a Google Translate-et. Ezek konkrét teszteredményekre vonatkozó projektállítások, nem általános minőségi garanciák. Az értékeléseket az EvalEval Coalition Every Eval Ever sémájában teszik közzé; külön magyar nyelvű eredmény az ismertetett adatokból nem derül ki.
TECH-SZÓTÁR
- Nyílt súlyú modell
- A modell megtanult paraméterei letölthetők, így a modell saját környezetben is futtatható.
- Multimodális
- Többféle adatot, például szöveget, képet és hangot kezelő modell.
- SFT
- Felügyelt finomhangolás, amelyben példák alapján tanítják a modellt a kívánt válaszadásra.
- Megerősítéses tanítás
- Olyan tanítási eljárás, amely jutalmazással tereli a modellt a kívánt eredmények felé.
» Követett téma: AI · régió: EURÓPA · kulcsszó: nyílt modellek